告别会话失忆与上下文污染:10万星开源记忆引擎 claude-mem 架构深度剖析
核心速览:
• 工程痛点: 编码智能体在新开会话后陷入“完全失忆”,而传统 RAG 一股脑塞入上万 Token 历史会导致上下文污染、注意力稀释和高昂开销。
• 架构解法: 借助生命周期钩子(Hooks)静默捕获操作、本地 Bun + SQLite FTS5 高效存储,配合“渐进式披露”(Progressive Disclosure)三层检索模式。
• 落地收益: 节省约 90% 的上下文 Token 消耗,使智能体能够在几十个会话之后仍能精确调取历史决策与代码修复脉络。
在日常使用 Claude Code、OpenClaw 或各类终端编码智能体时,几乎所有开发者都会踩中一个隐性陷阱:会话边界的割裂感。
早上刚调通的鉴权中间件缺陷、针对特定库踩坑得出的规避原则,一旦关闭终端或启动新任务,智能体就立刻重置为“白纸一张”。而如果通过系统提示词或外挂传统向量 RAG,把过去几个会话的日志全量灌进 Prompt,又会带来更严重的后果——单次请求被无用上下文撑爆,核心指令被稀释,甚至导致模型产生幻觉。在 GitHub 上迅速突破 10 万星的开源项目 claude-mem,正是针对这一死穴给出的工程解法。
01. 传统 RAG 的死胡同:上下文污染与注意力预算黑洞
很多团队在尝试为智能体补充长期记忆时,最直接的想法是做向量检索或全量历史注入。但工程实践证明,这种做法在编码场景下往往迅速恶化:
- 注意力被无关噪音淹没: 一次会话启动,系统直接塞进 15,000 Token 的历史对话、8,000 Token 的工具调用记录与 12,000 Token 的文件摘要。整整 35,000 Token 中,当前任务真正用得上的可能不到 2,000 Token(有效利用率不足 6%)。
- 缓存命中率暴跌: 主流大模型 API 均依赖 Prompt Caching 降低成本和延迟。动态变动且体积庞大的历史上下文会持续击穿缓存前缀,让每个回合的计费成本成倍上升。
- 历史过时信息的致命误导: 三天前被重构废弃的接口定义,若在未经精细筛选的情况下被检索召回,智能体会依据过时记忆编写代码,反而引发新的编译错误。
智能体需要的不是一个“大而全的废纸篓”,而是一个按需探查、渐进展开的知识索引。
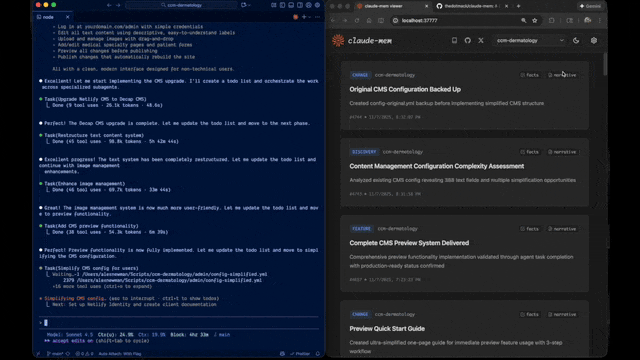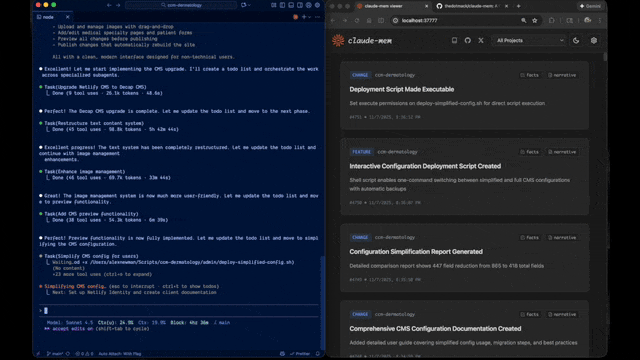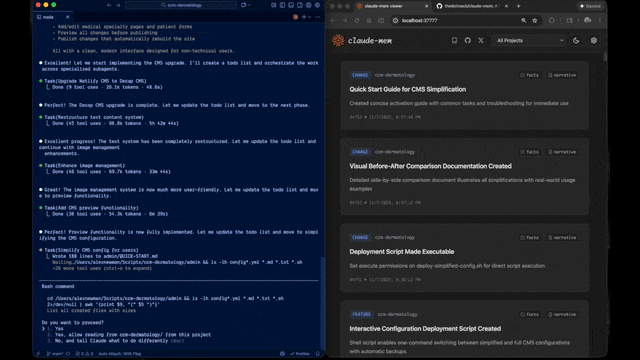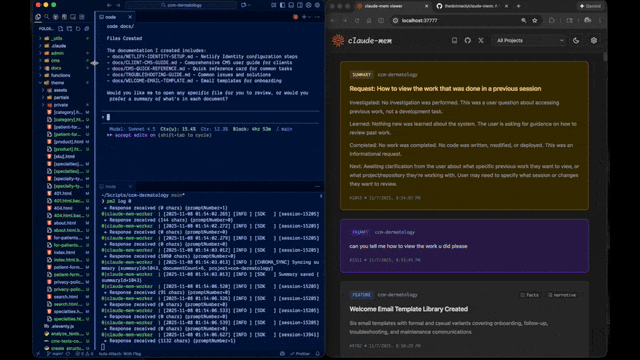
02. 核心架构拆解:零侵入的生命周期钩子系统
claude-mem 并未尝试去修改 Claude Code 或其他智能体底层代码,而是基于标准生命周期事件构建了一套轻量 Hook 总线:
SessionStart与SessionEnd:感知会话的生命周期边界,初始化当前工作区状态并保存终态快照。UserPromptSubmit:捕获开发者的目标意图,关联当前上下文的主任务分支。PreToolUse与PostToolUse:在智能体执行 Bash、文件读写或编辑时,静默记录操作输入、返回值与执行成败。Stop:会话被人工打断或异常退出时的恢复锚点。
每个钩子在触发时,仅执行一条轻量的非阻塞命令 claude-mem hook claude-code <event>,将结构化数据推送到后台常驻的 Worker 服务。该服务基于 Bun 与 Express 5 运行,在后台异步调用轻量模型对工具使用过程进行摘要与结构化提炼,绝不阻塞主交互界面的打字与代码生成。
03. 核心机制:渐进式披露(Progressive Disclosure)三层检索
这是 claude-mem 区别于普通知识库最精妙的设计。它将智能体检索记忆的过程划分为三层,层层递进:
渐进式检索法则:
不要直接把详情喂给模型,而是先告诉它“有哪些条目可用及其检索代价”,由模型自行判定是否需要进一步展开。
通过内置的 MCP(Model Context Protocol)工具,检索工作流被规范为标准的三个步骤:
- 第一层:高紧凑索引(search)
执行全文本与标签过滤,仅返回命中条目的 ID、标题、类型与极简元数据。单条结果仅占用约 50~100 Token。 - 第二层:时间线上下文追踪(timeline)
当模型发现某个问题相关的线索时,可以通过时间线工具查看该记录前后的事件关联,厘清排查的先后逻辑。 - 第三层:针对性详情拉取(get_observations)
模型最终仅对筛选出的 1~2 个核心 ID 发起批量获取请求(单条约 500~1000 Token),完成具体代码和结论的注入。
这种模式直接砍掉了 90% 以上的无效 Token 浪费,保证当前会话的主 Context Window 永远处于清爽状态。
04. 快速上手与多 Agent 兼容性
部署安装过程极为简捷。本地拥有 Node 20+ 环境后,直接执行一行命令即可完成安装与钩子注册: