告别按字计费!深入拆解 87K+ Star 开源语音神器 VoiceStudio:把 646 种语言克隆与视频配音搬进本地显卡
做海外视频出海、游戏配音或有声书制作,声音往往是最花钱的环节。闭源商业服务按字符计费,长篇文本跑几轮校对成本直线上升,更别说数据还要上传云端。开源项目 VoiceStudio 最近在社区引起广泛关注,它把原本依赖昂贵 SaaS 的全套语音工作流,搬到了普通开发者的本地显卡上。
痛点:商业语音服务的隐形成本
用过商业 TTS 接口的开发者大多遇到过类似问题:
- 按字计费的试错代价:语音合成极难一次成型,语调断句微调三次,费用就翻三倍。长篇内容或批量生产时账单增长很快。
- 版权与声音锁定:你在平台精调的专属声音资产无法迁移,一旦服务商调整规则或下架模型,前期的声音积累全部归零。
- 音频资产隐私:商业剧本、未公开宣传片或内部培训素材上传第三方服务器,企业合规审核往往通不过。
- 多语言工作流断层:跨国配音通常要在克隆工具、字幕工具、时间轴对齐软件之间来回倒腾格式。
亮点:VoiceStudio 的工程整合与技术突破
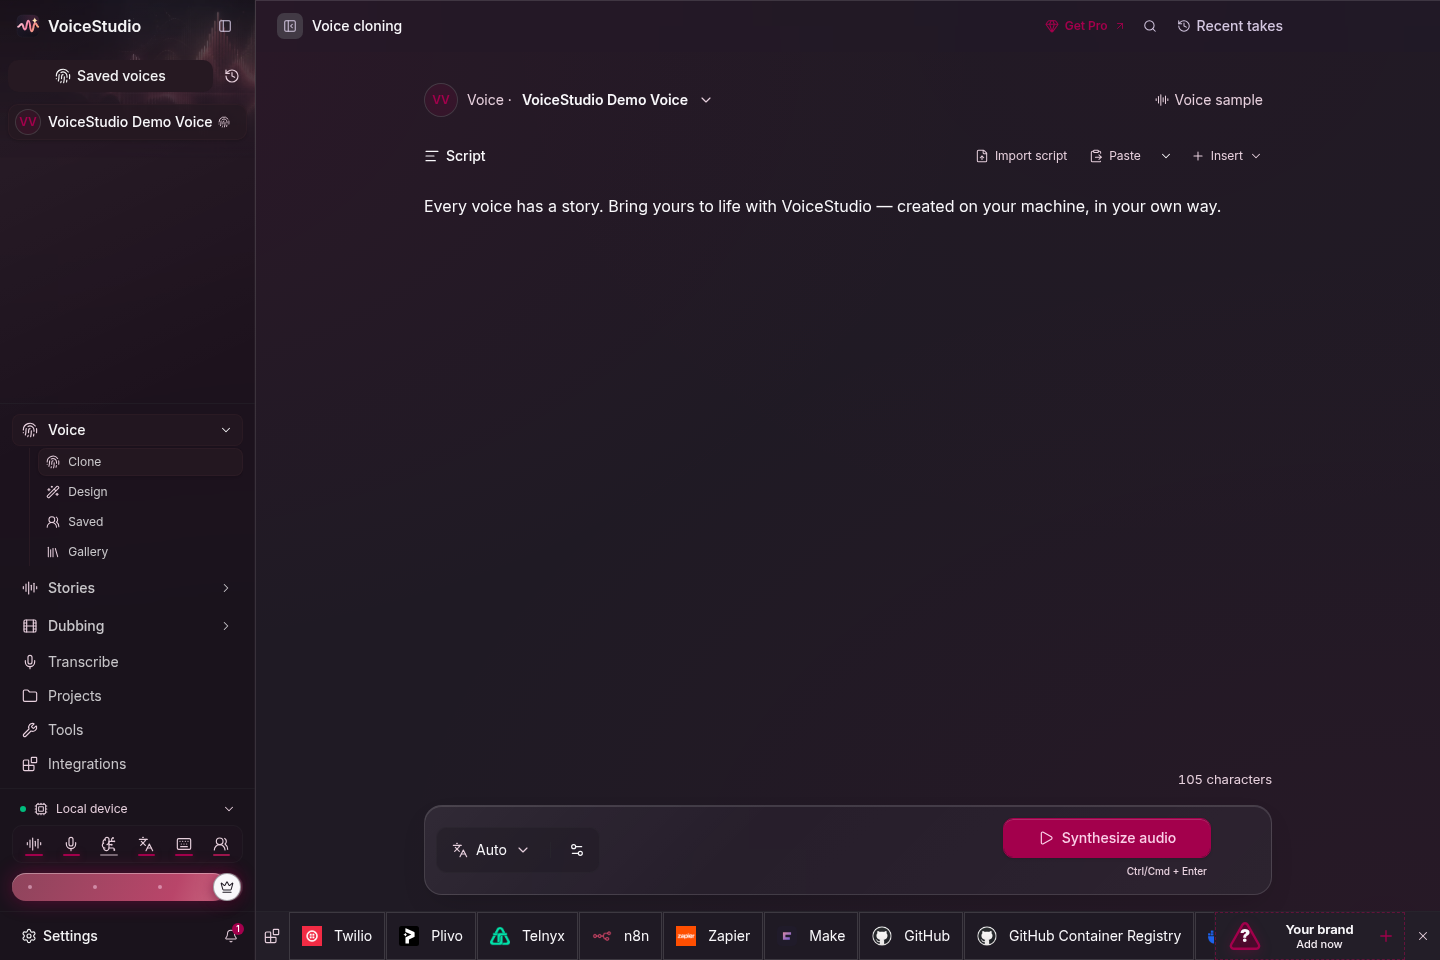
VoiceStudio 之所以能拿到近 9 万 Stars,核心在于它不是简单给模型包一层 WebUI,而是做了一套现代化的本地音频制作中枢:
- 646 种语言开箱即用:默认引擎基于 k2-fsa/OmniVoice 构建,同时内嵌 CosyVoice 3、IndexTTS 2.5、GPT-SoVITS 等主流开源引擎,覆盖主流语种与小众方言。
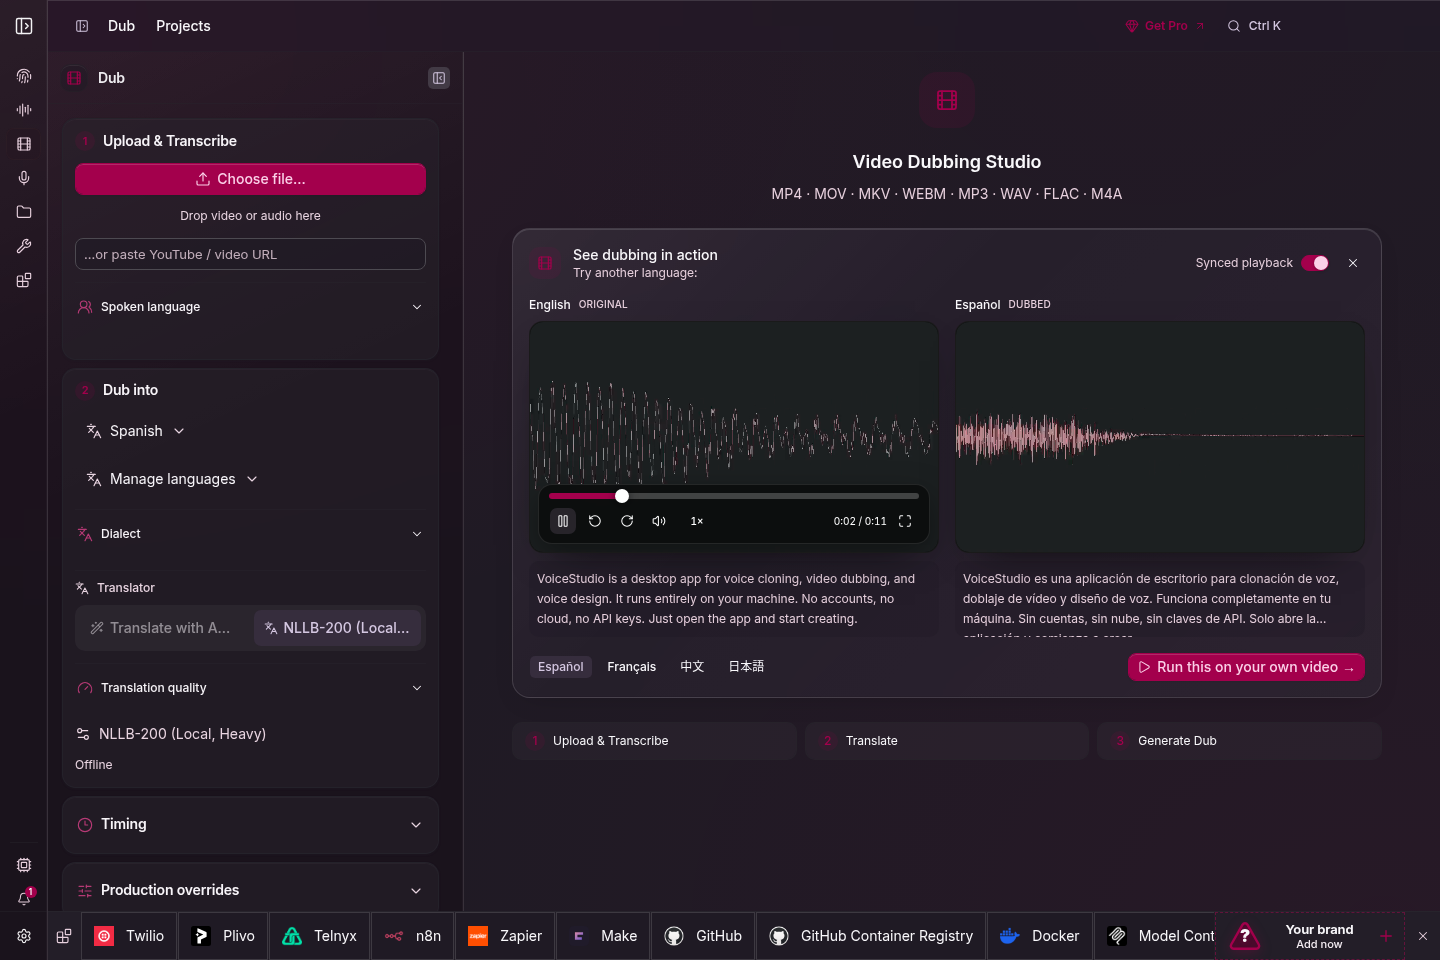
- 全链路视频自动配音:内置时间轴同步与人声分离。导入视频后,WhisperX 自动转录切片,直接在同一界面完成目标语言替换并重新混音输出。
- 原生跨平台硬件加速:NVIDIA 走 CUDA,苹果设备走 Metal(MPS),Windows/Linux 下 AMD 显卡与集显还能走 Vulkan GGUF 量化加速,甚至纯 CPU 也能完成离线推理。
- 开放 Local API 与 MCP 协议:提供本地兼容服务与 MCP(Model Context Protocol)接口,Cursor、Claude Code 或本地自动化脚本能直接通过标准工具调用让系统发声。
实战:手把手安装与基础配置
VoiceStudio 已经完成从旧版 Tauri 到 Electron 的架构重构,提供了免编译的一键脚本:
1. 快速脚本安装
在 macOS 或 Linux 终端执行官方脚本:
# macOS / Linux 一键安装
curl -fsSL https://voicestudio.sh/install | sh

# 如果遇到网络受限,可直接从 GitHub 源码脚本拉取
curl -fsSL https://raw.githubusercontent.com/debpalash/VoiceStudio/main/scripts/install.sh | sh
Windows 用户在 PowerShell(管理员权限)中运行:
irm https://voicestudio.sh/install.ps1 | iex2. 开发者源码运行(可选)
如果你需要二开界面或对接私有模型,可以走源码构建方式(依赖 Bun 与 Node 22):
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run setup:api    # 准备后端 Python 依赖与推理运行时
bun run dev          # 启动 Electron 开发调试窗口
上手使用:完成你的第一次本地声音克隆与配音
步骤一:模型加载与硬件确认
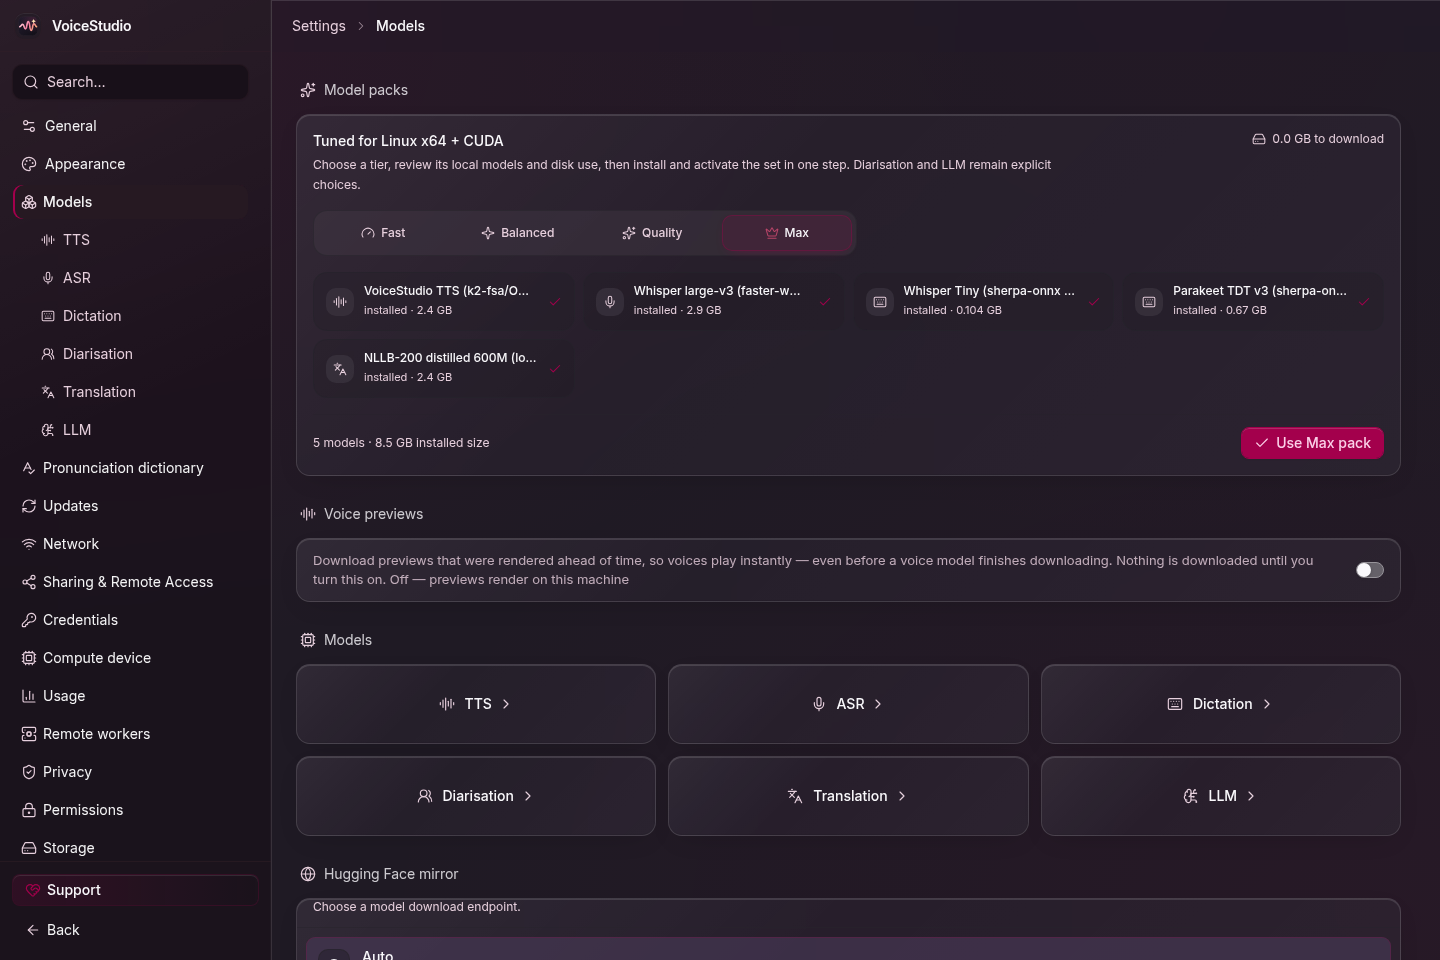
首次启动后,点击左侧菜单的 Local models。推荐先下载默认的 OmniVoice 或轻量版 IndexTTS。系统会自动识别显卡驱动(如 CUDA 或 Metal),确认对应加速状态亮起即可。
步骤二:添加声音参考(Voice Reference)
进入 Voice cloning 工作区:
- 准备一段 5 到 15 秒的干净人声录音(无明显背景混响或噪音的 WAV/MP3 格式最佳)。
- 将音频拖入参考面板,点击 Analyze,算法会自动抽取发音特征与语调包络。
- 在下方文本框输入目标台词,选择语言后点击 Generate。在 8GB 显存以上的显卡上,一句话的推理时间通常在 1 秒以内。
步骤三:视频配音工作流(Video Dubbing)
切换到 Dubbing 面板:
- 导入需要配音的视频文件,系统内置的 WhisperX 会自动将原声识别人声并分轨。
- 在时间轴列表直接修改翻译后的文本,或给不同说话人分配之前克隆好的角色音色。
- 确认时间轴对齐后点击导出,即可得到带全新人声音轨的视频成片。
总结与选型建议
对于个人内容创作者、小团队或对数据资产有保密要求的开发团队,VoiceStudio 证明了高质量语音合成不再是商业云服务的专利。把推理引擎部署在本地,不仅省去了长期订阅费用,也真正把声音模型和生成资产的所有权留在了自己手上。