终身个性化导师:解构 4.7 万星开源智能体工作区 DeepTutor
用过大语言模型辅导学习的人大概都有类似体会:把一道推导题扔给通用模型,它往往毫不犹豫地直接吐出完整步骤与最终答案。看似效率极高,但学习者并未真正经历卡壳、拆解、尝试与顿悟的认知过程。一旦换了题目变体,依然束手无策。更让人头疼的是上下文遗忘:每次开启新会话,模型对你过去的薄弱环节、已掌握的概念和认知偏好一无所知,只能从零开始。
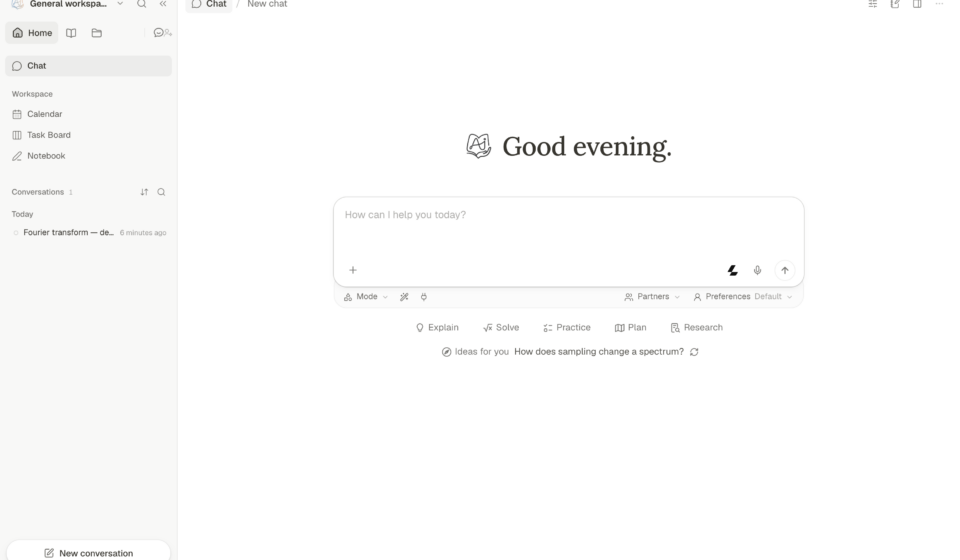
香港大学数据智能实验室(HKUDS)开源的 DeepTutor 正是针对这套断层设计的智能体原生学习工作区。项目在 GitHub 上线后迅速积累了超过 4.7 万颗星,并在近期保持着单日 2000+ 星的增长势头。它没有把精力耗费在花哨的聊天皮肤上,而是将辅导、解题、评测、研究与可追溯记忆整合进一套统一的运行时中。
从单点对话到多循环运行时
绝大多数学习辅助工具只是在通用聊天界面外套了一层教学 System Prompt。这种轻量方案在面对严肃的知识构建时显得格外脆弱。真实学习过程包含了阶段完全不同的认知动作:苏格拉底式的循序提问、针对公式的推演验证、基于大纲的自主评测,以及跨文献的深度研读。
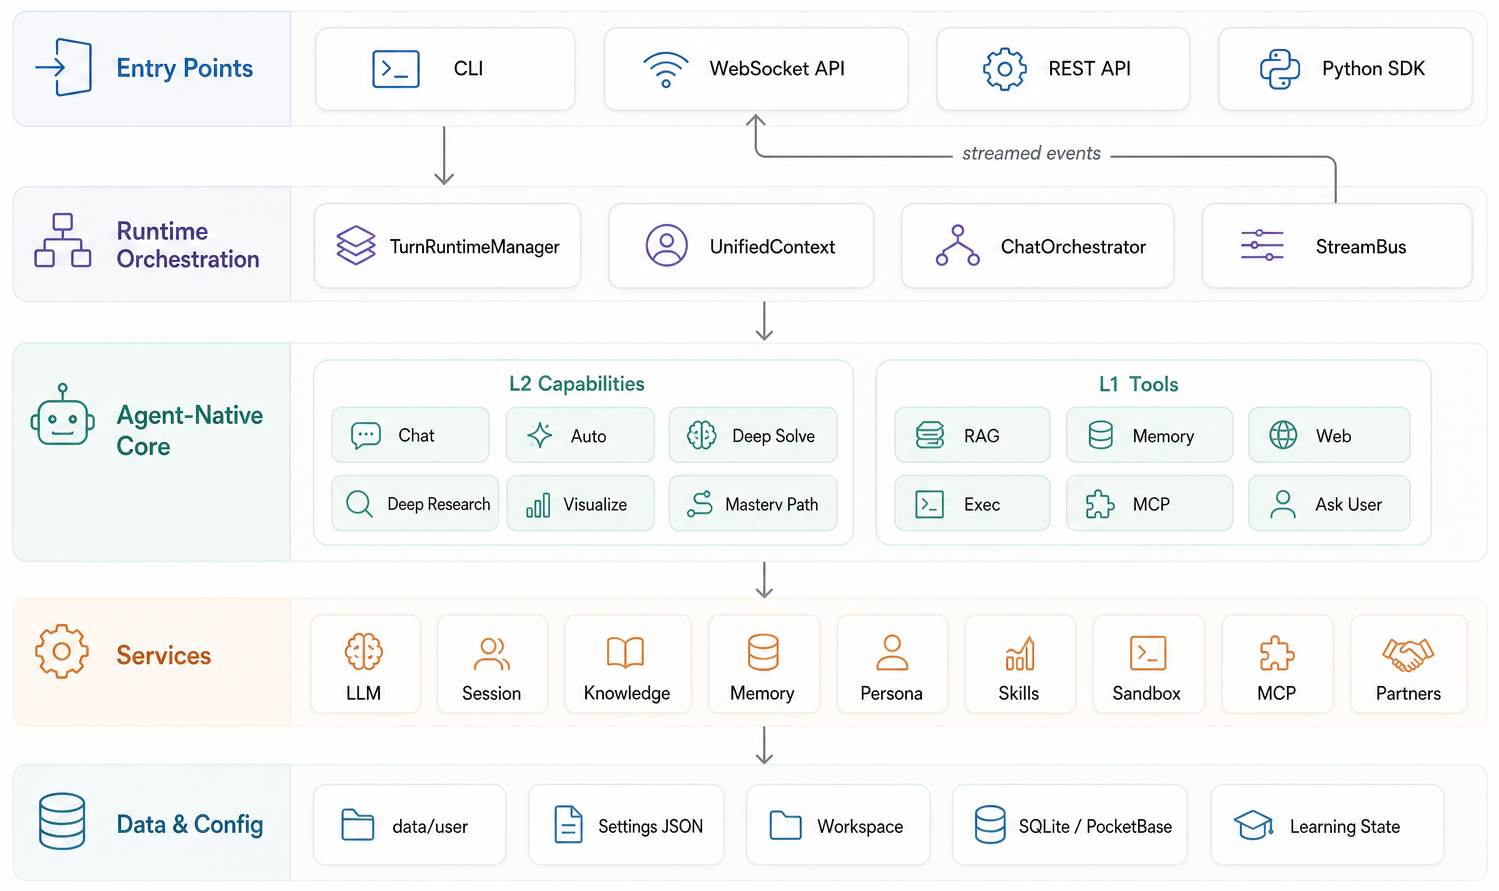
DeepTutor 在底层将单一的 Prompt 对话拆解为多个独立的执行循环。在它的设计中,Chat、Ask Questions、Quiz、Research、Visualize、Solve、Mastery Path 等模块共享统一的上下文与记忆库,但各自运行独立的调度循环:
- 启发式问答(Ask Questions):强制抑制大模型直接输出结论的冲动,根据学生的回答切片判定理解深度,仅提供反思支架与阶梯式线索。
- 测验与掌握度追踪(Quiz & Mastery):自动根据阅读材料或错题生成针对性测试题,配合客户端渲染引擎即时评判推导过程,动态更新能力雷达图。
- 沉浸式研读(Reading):支持将本地论文、电子书、以及视频流链接(Bilibili / YouTube)纳入阅读器,支持带时间戳的边看边问与转录检索。
- 研究与推演(Research & Solve):集成沙箱代码执行与符号推导工具,用于验证数学演算与生成可视化图表。
透明可审计的 L1-L3 分层记忆网络
市面上许多所谓的长记忆方案,本质上只是把历史摘要无脑塞进向量数据库,检索时常常出现上下文污染或事实错位。DeepTutor 采用了一种结构化的三层记忆架构,并且向用户开放了完整的可视化编辑能力。
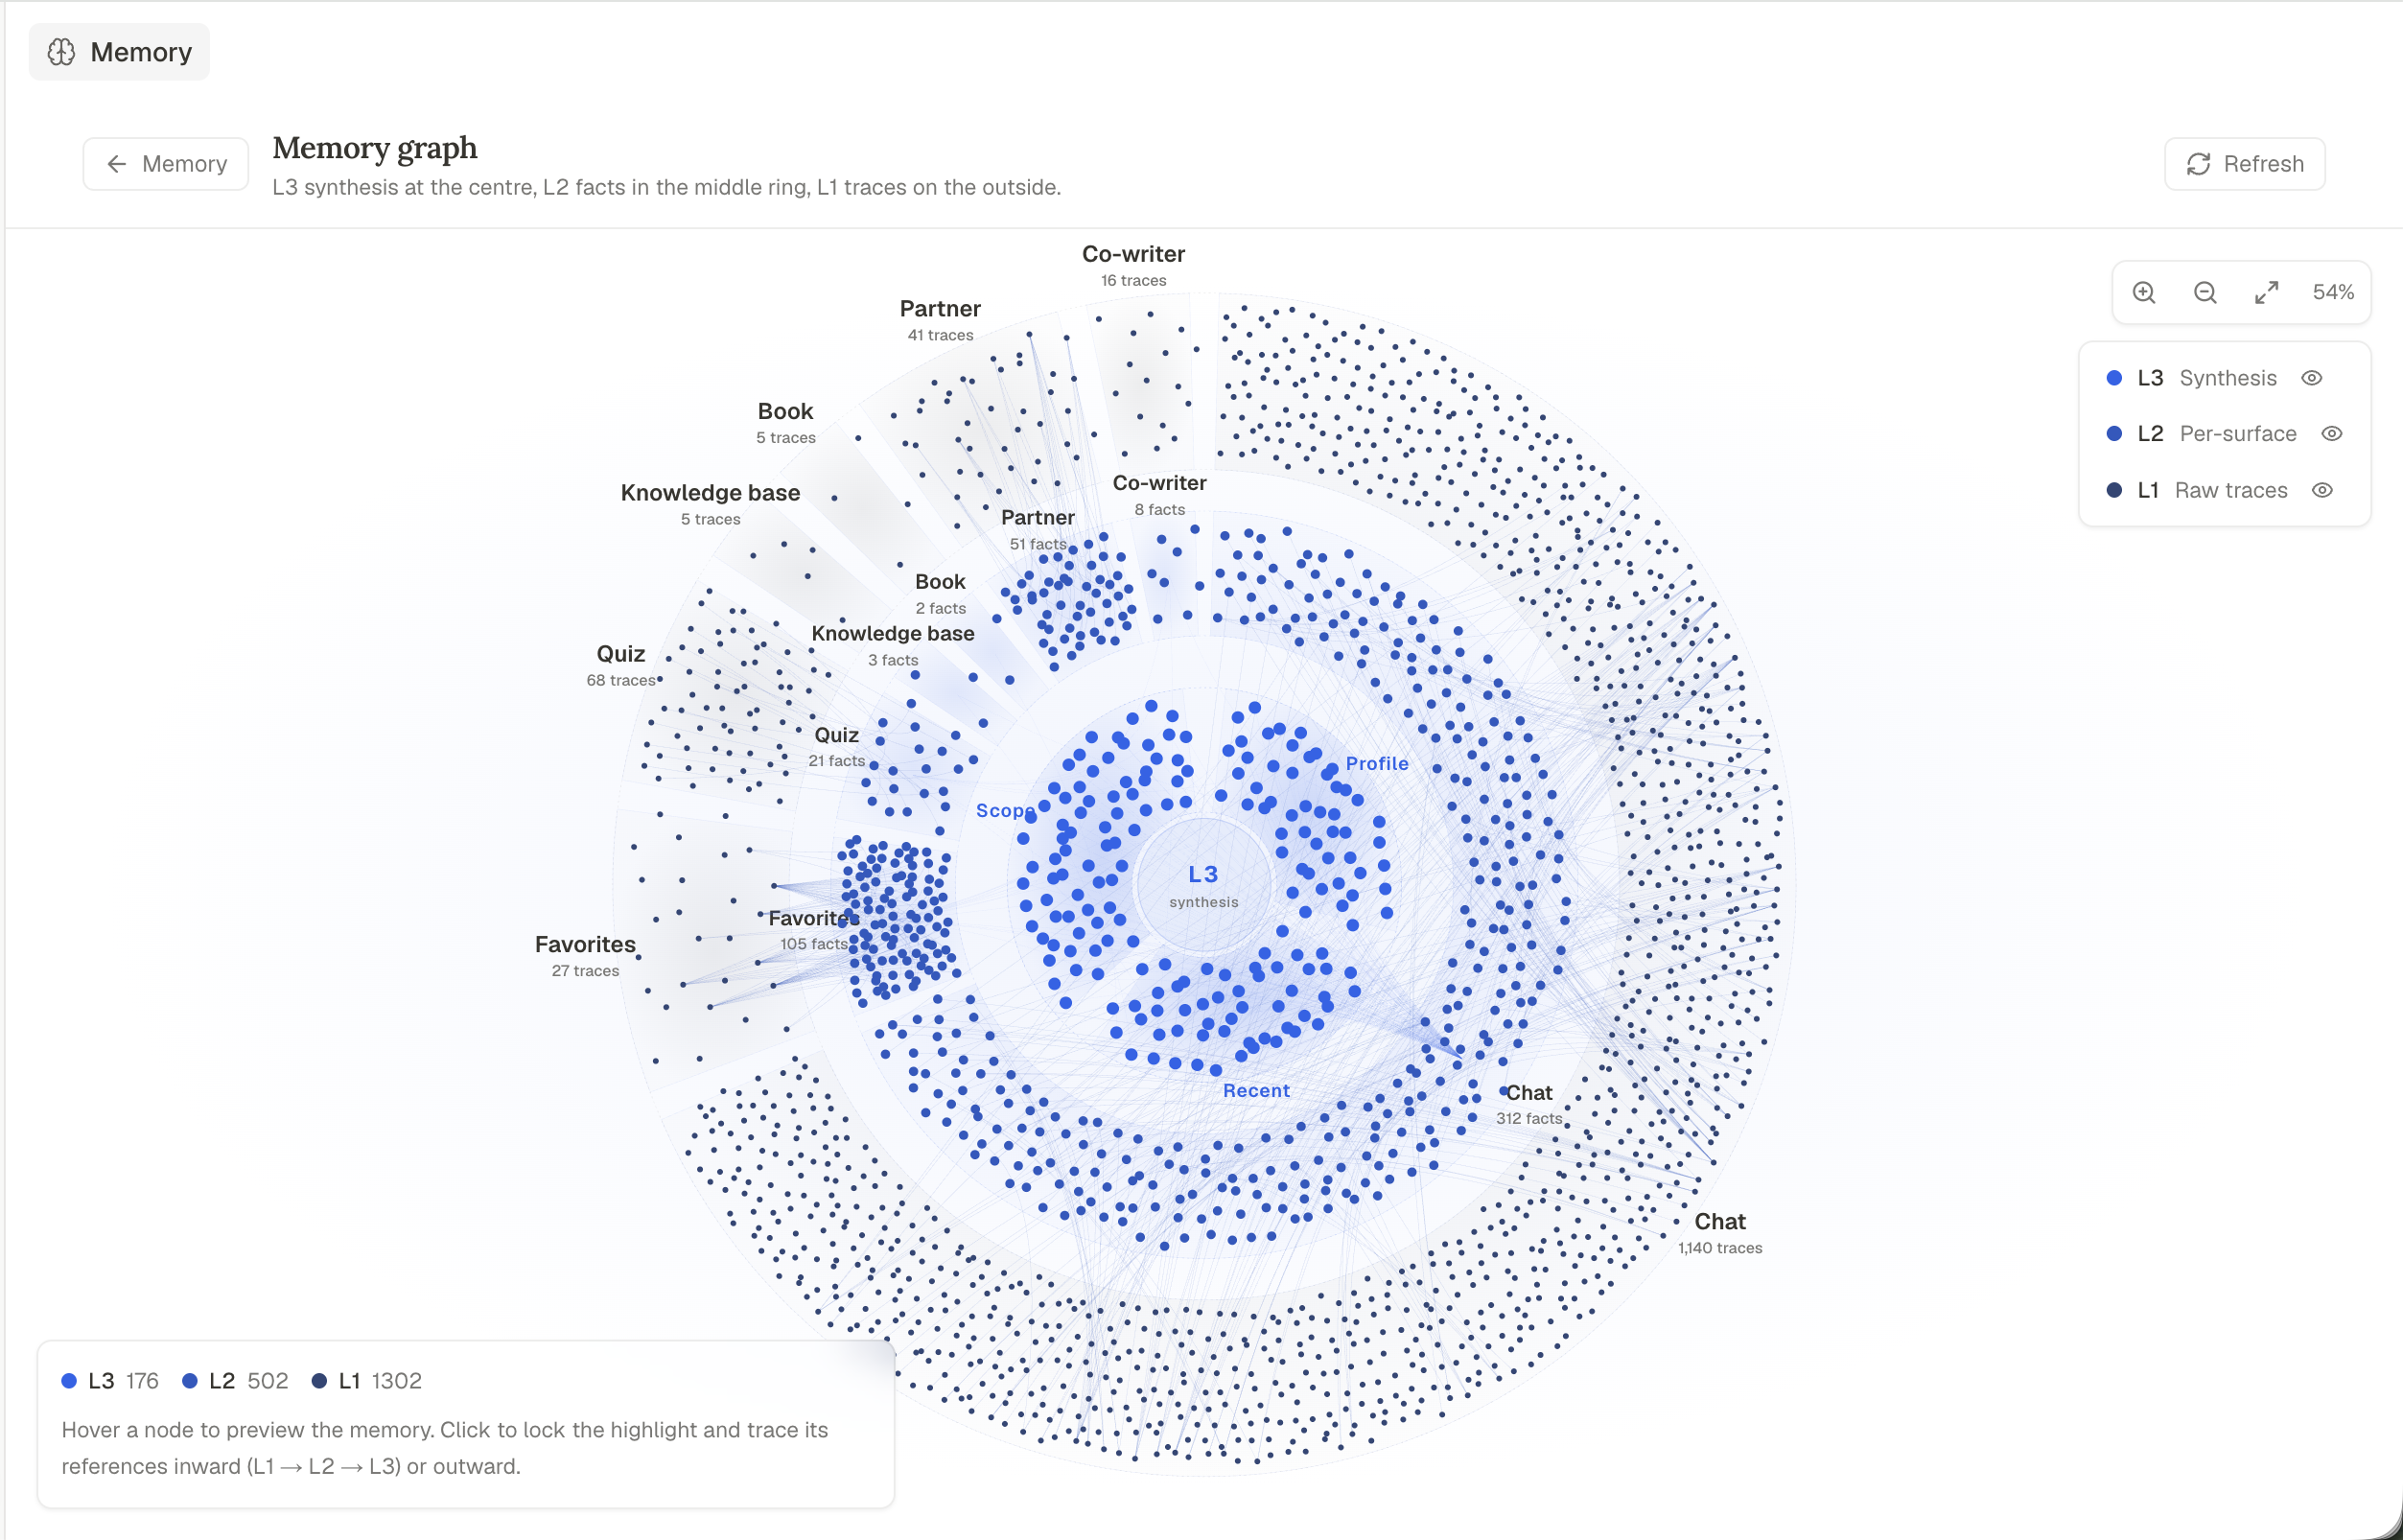
这套三层记忆机制的具体流转逻辑如下:
- L1 原始痕迹(Trace):完整记录交互过程中的每一次问答、做题正误、代码提交与停留时长,作为最底层的不可变事实证据。
- L2 显式事实(Surface Facts):由后台提取智能体从 L1 行为中提取的原子画像,例如特定的知识盲区(如未理解反向传播中的梯度链式法则)或偏好的解释风格。
- L3 高阶综合(Synthesis):基于全量 L2 事实推演出的全局学习者模型与掌握度评估轨迹。
值得肯定的是它的审计设计:通过前端的 Memory Graph,你可以清楚看到某条 L3 结论究竟依赖了哪些 L2 事实,而这些事实又来自哪一次交互的 L1 证据。如果你发现智能体产生了误判,可以直接在图谱中编辑节点或切断关联,无需担心错误记忆持续污染后续的教学逻辑。
多引擎 RAG 与工作区安全沙箱
在知识库检索层面,DeepTutor 没有绑定单一的检索框架,而是根据使用场景提供了多种 RAG 接入方案:
- LightRAG 原生角色模型:采用实体与关系双层索引。在回答概括性架构问题时调用高层关系图谱,在细微概念核对时回退到局部实体切片。
- 多源知识库生态:兼容 Obsidian Vault、MarginNote 4、Kiwix ZIM 离线百科以及自建的 WeKnora 知识库,学生原本积累的笔记可以无损接入系统。
- 内容工作区边界隔离:智能体在辅导与实验过程中产生的文件全部被约束在 outputs 目录下,对本地工作区目录的修改需要经过显式的一次性授权确认,避免自动化执行误伤用户原始文件。
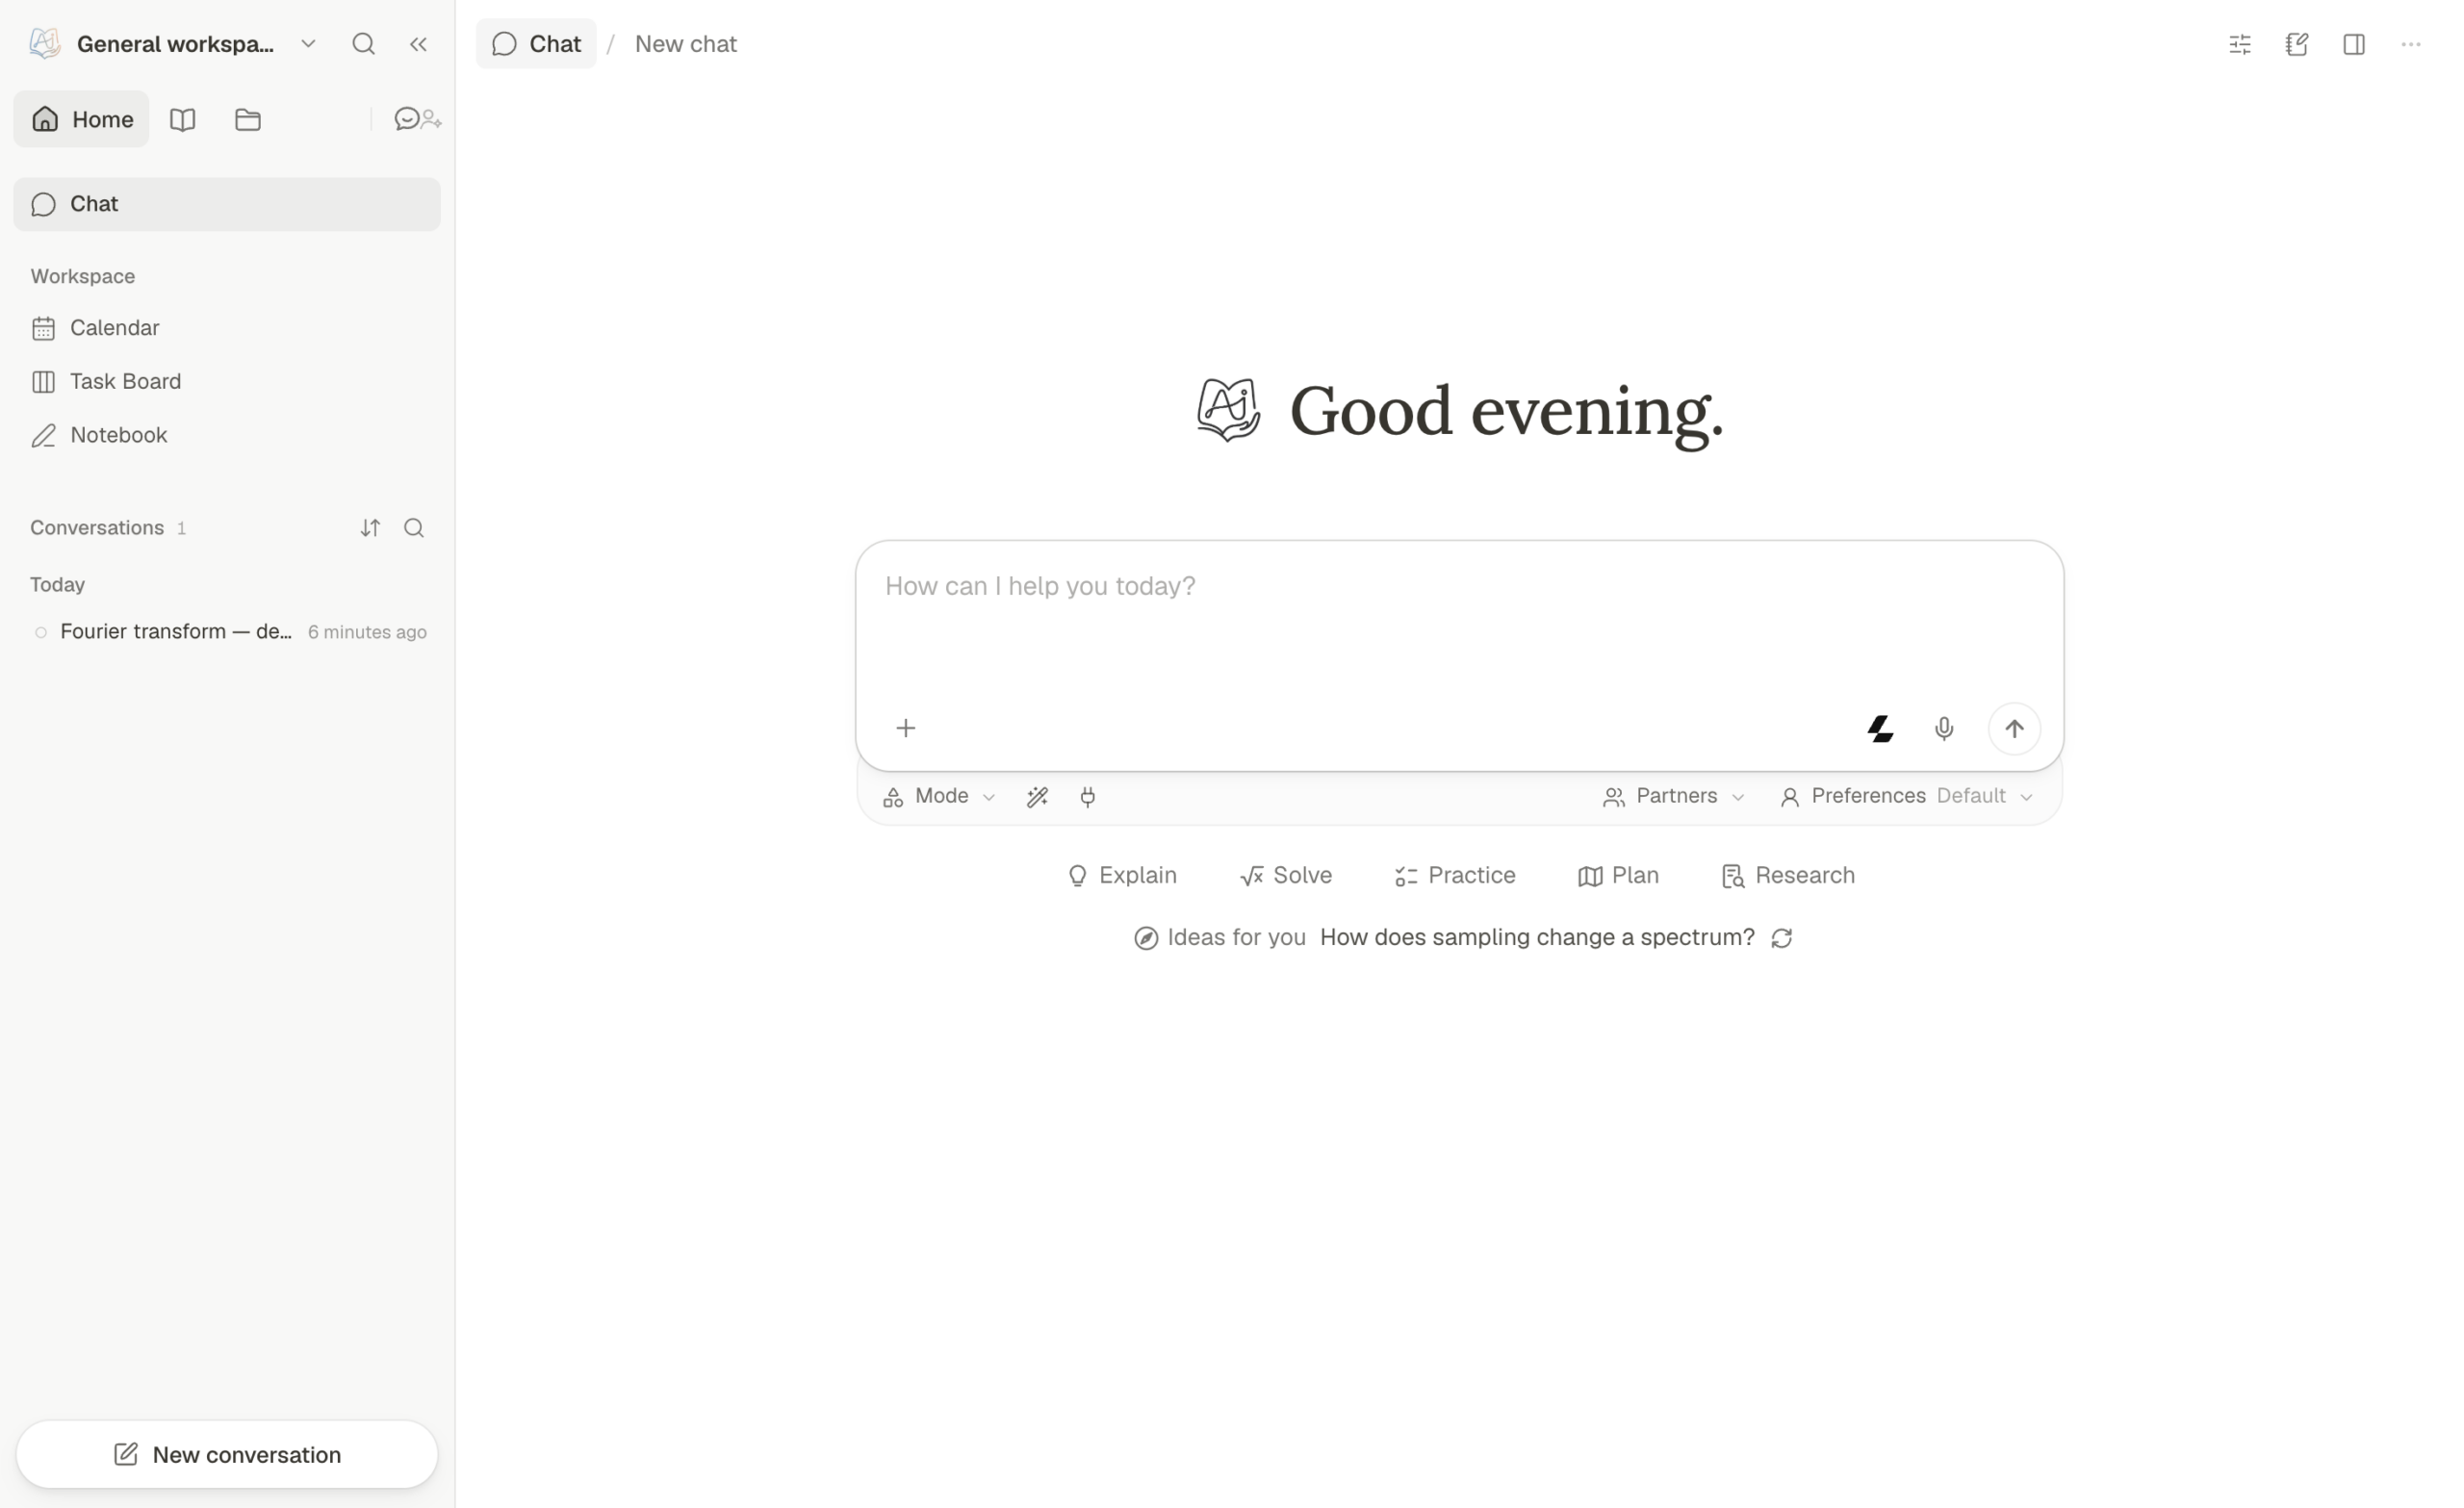
本地快速部署与上手体验
DeepTutor 采用 Python 3.11+ 作为后端服务,前端则基于 Next.js 16 构建。官方提供了开箱即用的 Docker 镜像与 PyPI 模块化安装两种途径。
1. Docker 一行命令试用
这是最省心的体验方式,无需在宿主机折腾 Node.js 与 Python 编译环境:
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
容器启动后直接在浏览器访问 http://127.0.0.1:3782。进入系统后在 Settings 页面配置你的大模型 API Key(支持主流商业模型与本地 Ollama 实例)即可开始交互。数据卷 deeptutor-data 会持久化所有记忆、进度和配置。
2. Python 模块化环境安装
如果你希望在已有 Python 环境中以服务方式常驻运行,可以使用官方发布的 PyPI 完整包:
mkdir -p ~/deeptutor-workspace && cd ~/deeptutor-workspace
pip install -U "deeptutor[full]"

# 初始化基础配置(交互式配置端口、大模型服务与向量嵌入源)
deeptutor init

# 启动前后端服务
deeptutor start
在执行 deeptutor init 时,系统会引导你配置服务端口(默认前端 3782、后端 8001)与模型供应商。如果你需要视频课程中音频的转录能力,系统会利用本地系统的 FFmpeg 处理音频切片,建议提前通过系统包管理器装好 ffmpeg 工具包。
客观总结与使用建议
纵观整个开源社区,把 LLM 包装成刷题助手的项目并不罕见,但像 DeepTutor 这样把重点放在认知认知负荷管理、分级记忆回溯和严肃知识库体系的项目屈指可数。它不是简单地让模型来当解题计算器,而是搭建了一套可持续陪伴学习者成长的认知支架。
如果你正在寻找一个能沉淀个人知识库、辅助研读文献与长期追踪自身学习盲区的智能体助手,DeepTutor 现阶段的设计和工程实现值得你部署体验。
参考链接与项目资源
- GitHub 开源仓库:https://github.com/HKUDS/DeepTutor
- 官方文档与功能指南:https://deeptutor.info/
- 学术论文预印本(arXiv):https://arxiv.org/abs/2604.26962